 Вход на сайт
 Рассылка


В поисках эталона
Компания «Лада Цифра» создала систему Golden Record в сегменте автозапчастей. Она позволяет соотносить товары поставщиков с базой-эталоном, где содержатся приведенные к единому виду объекты номенклатуры, к которым привязаны данные из внешних источников в результате синдикации. Система обладает высокой пропускной способностью и экономит десятки часов на выполнение задач ручного сопоставления
Потребность в создании Golden Record встает перед любой системой обработки данных. Если два и более источника хранят информацию об одной сущности, они гарантированно разойдутся. Точнее уже разошлись.
Банки сталкиваются с этим, когда объединяют клиентские профили из разных систем. Маркетплейсы – когда сотни продавцов
Дмитрий Хайтин,
руководитель группы разработки DWH в компании «Лада Цифра».
Имеет более пяти лет опыта работы с данными. Руководит разработкой DWH и других дата-продуктов компании «Лада Цифра». Ранее занимал позицию инженера данных в «Авито», где поддерживал и развивал хранилище данных на 1 ПБ. Первоначальный бэкграунд – маркетинговая аналитика.
предлагают один и тот же товар под разными названиями. Медицина – когда история болезни пациента хранится в нескольких больничных базах. В нашем случае источники данных – это каталоги автозапчастей с десятками тысяч объектов номенклатуры.
Построение задачи
Данные о номенклатуре поступают из десятков источников – и каждый называет одно и то же по-разному. Например, один и тот же тормозной диск может называться «диск торм. LADA», «brake disc VAZ» или «тормозной диск 2110».
Кириллица или латиница, нижние подчеркивания или дефисы, пробелы, опечатки – способов неправильно занести артикул в базу бесчисленное множество. Банально, но даже английская буква «а» вместо русской или артикул и бренд, перепутанные местами, могут служить причиной путаницы. Единого стандарта нет, а значит, почти в любой внешней системе будут расхождения с эталоном.
Раньше менеджеры сопоставляли артикулы вручную через «Яндекс Таблицы». Это работало, пока каталог был небольшим. При миллионах объектов номенклатуры и десятках поставщиков это не масштабируется – ни по скорости, ни по качеству.
Сервис попросту не предназначен для такой работы. Одновременное редактирование может порождать конфликты, миллионы строк не подгружаются в браузере, а ресурс менеджеров сильно ограничен. Тут и возникает потребность в качественном дата-продукте.
Что мы хотели:
- создать эталонную базу автозапчастей, которая пополняется в полуавтоматическом режиме;
- иметь интеллектуальную систему сопоставления с возможностью итеративной доработки и улучшения;
- исключить попадание в базу-эталон непроверенной информации;
- обрабатывать до миллиона задач в час;
- уметь численно оценивать эффективность системы.
На выходе – эталонная база автозапчастей, сервис для сопоставления, мониторинг и наблюдаемость. Очертания задачи понятны, дальше – дело за конкретикой.
Архитектура синдикации
На схеме изображено два контура – быстрый и медленный. В первом стриминговый движок сразу находит сопоставление в базе-эталоне и отдает клиенту ID товара. Во втором – задача на сопоставление уходит в очередь к MDM-менеджерам на ручное уточнение. Разделение на эти два контура позволяет нам за секунды обрабатывать входящие задачи и значительно снизить нагрузку на менеджеров. Теперь детальнее.
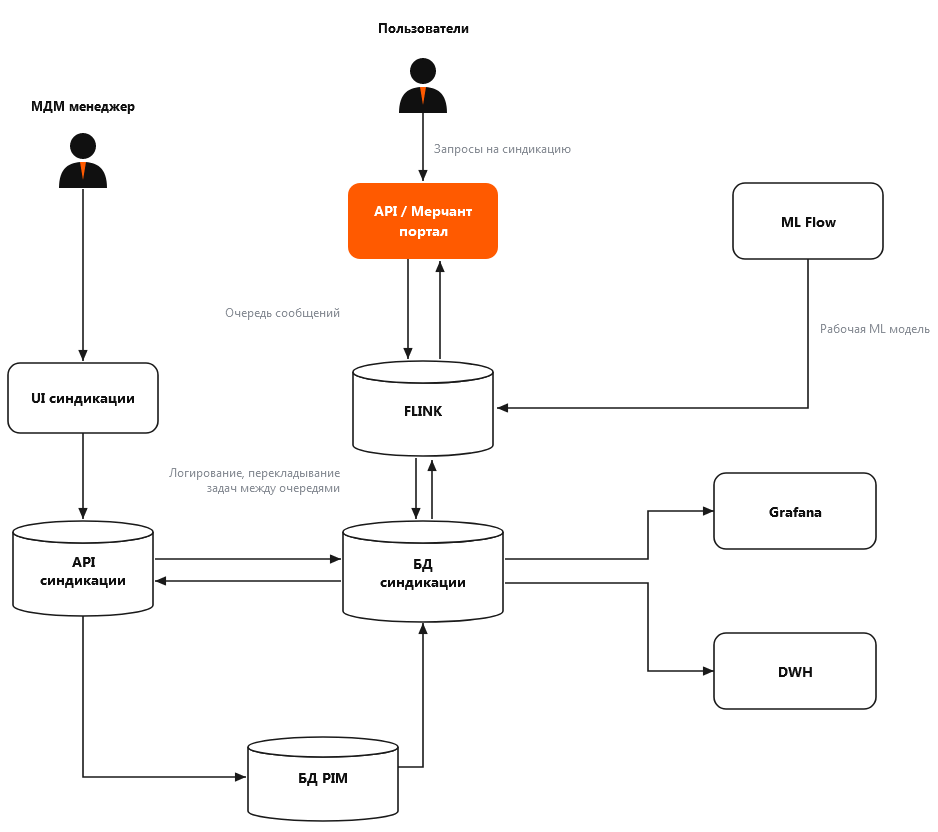
В сердце системы находится Flink – фреймворк для потоковой обработки данных. Он принимает из очереди сообщений задачи на синдикацию и пытается найти соответствие в базе-эталоне. При этом уже сопоставленные объекты номенклатуры хранятся в горячем кэше. Это снижает оверхед на повторную обработку уже встреченных сущностей. Перед поиском входные данные претерпевают цепочку детерминированных преобразований к эталонному виду.
«Лада Цифра»
Дочерняя IT-структура АвтоВАЗа и компании «Лады-Имидж», которая охватывает комплексную сеть поставки автокомпонентов, распределительных центров, оптовых операторов, розничных магазинов и онлайн-сервисов. Основана в ноябре 2023 года как центр IT-решений для бренда Lecar.
Эти преобразования – набор наших эвристик, которые были сформулированы при анализе структуры данных. Flink гарантирует exactly-once обработку: при сбое система восстанавливается с последнего чекпоинта, не теряя и не дублируя события. Это критично при объемах в миллионы сообщений – потеря даже небольшой части данных была бы для нас неприемлема.
Примеры:
- приведение к нижнему регистру и удаление пунктуации;
- схлопывание пробелов: King Tony и KingTony – одно и то же;
- устранение гомоглифов: кириллические и латинские буквы, неотличимые визуально, унифицируются по написанию;
- очистка бренда от юридических форм (ООО, GmbH), географических приставок и шумовых слов;
- канонизация синонимов: разные написания одного бренда приводятся к единому эталонному виду.
Записи, для которых не найдено соответствие, должны быть каким-то образом обработаны. С этой целью на Kotlin реализован бэкенд для ручной обработки. MDM-менеджеры в UI могут просмотреть такие записи и совершить с ними действия: отклонить, назначить соответствие среди существующей номенклатуры или создать новую. Кроме того, система рекомендаций предлагает ближайших вероятных кандидатов на потенциальное сопоставление.
Ранжирование строится по нескольким признакам: схожесть нормализованного артикула, близость бренда после канонизации, совпадение категории. Чем чаще менеджеры подтверждают или исправляют такие предложения – тем точнее становится ранжирование в будущем.
Все решения – алгоритмические и ручные – сохраняются в SCD2-таблице. Это стандартный подход к хранению истории изменений: каждая версия записи содержится с временными метками валидности, что позволяет восстановить состояние системы в любой момент прошлого. Таким образом мы расширяем и дополняем знание системы о домене. Эта таблица служит кэшем для повторной обработки уже решенных задач, а также источником данных для обучения ML-алгоритмов.
Узкое место системы – необходимость human in the loop, человеческого решения касательно записей, которым не удалось найти соответствие в базе-эталоне. При нечетком сопоставлении и использовании ML-алгоритмов мы вынуждены принимать взвешенное и компромиссное решение между скоростью и эффективностью. Что лучше: массово выдать решение для миллиона объектов с вероятностью ошибиться или же прогнать неопознанные 5% через ручной процесс?
Ответ зависит от конкретного домена и требований. В нашем случае ставка сделана на детерминированный подход: справочник эталонов обеспечивает воспроизводимость – один и тот же вход
Артем Зуев,
директор по данным в компании «Лада Цифра».
От прототипа на двух Jupyter Notebooks до полноценного сервиса с вычислительным движком, бэкендом, фронтендом и большим бэклогом понадобилось полгода. Были пересмотрены все компоненты, и, если бы Тезей принимал этот корабль после всех работ, он бы его не узнал – вопреки расхожему философскому парадоксу.
всегда дает один и тот же ответ, который можно проверить и объяснить. ML при этом не уходит на второй план: каждое решение менеджера пополняет обучающую выборку, и в перспективе модель возьмет на себя большую часть этой работы. Вывод прост: если мы не уверены на 100%, то зовем на помощь человека.
Конечно, такую систему нужно мониторить и уметь оценивать ее эффективность. Для этого мы используем два инструмента: Grafana и DWH. Первый – стандарт индустрии для Observability, а с помощью второго строятся аналитические дашборды на бизнес-метрики, которые позволяют продакт-менеджерам и стейкхолдерам проекта принимать решения о дальнейшем развитии продукта.
Grafana позволяет нам держать руку на пульсе сервиса – лаг вычитки из Kafka, утилизация ресурсов, пропускная способность системы. Бизнес-метрики – это все, что касается результатов работы алгоритма и того, как менеджеры взаимодействуют с системой: процент автоматических сопоставлений, время от заведения задачи в медленный контур до принятия решения менеджером, динамика расширения базы-эталона.
Система позволяет нам обрабатывать большие объемы данных в режиме реального времени, подключая все больше внешних клиентов для создания Golden Record. При этом чем больше данных, тем выше эффективность. Бизнес-правила уточняются, эвристики улучшаются, а принятые решения служат источником данных для обучения новых версий алгоритма.
Улучшение работы с ML и внедрение LLM – ближайшие шаги для повышения качества системы. И в этом как раз будет помогать накопленная база-эталон, ведь чем больше объем размеченных данных, тем более точные модели мы сможем обучать. Более эффективные эмбеддинги, лучше семантический поиск. Наша конечная задача – построить автоматизированную систему, которая сможет выполнять свою работу с минимальным участием человека, но с высокими гарантиями надежности.
Результаты внедрения
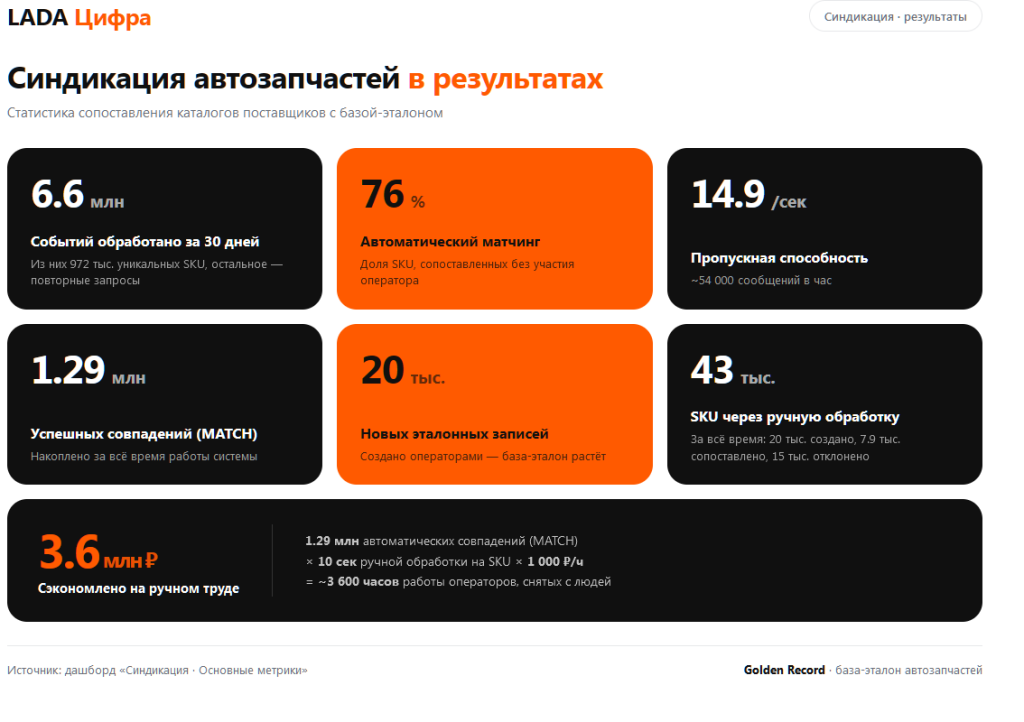
За последние 30 дней пайплайн обработал 6,6 миллиона событий, из которых 972 тысячи уникальных SKU. Остальное приходится на повторные запросы от пользователей. Пропускная способность – 14,9 сообщений в секунду (около 54 тысяч в час). При этом 76% всех SKU сопоставляются автоматически, без участия оператора. Оставшиеся 24% распределяются между No_Match (артикул не нашел соответствия в эталоне) и No_Brand (поставщик не передал атрибут бренда вовсе) – именно они формируют очередь для MDM-менеджеров.
За все время работы система накопила 1,29 миллиона успешных совпадений (Match), 449 тысяч записей без совпадения (No_Match) и 250 тысяч записей без бренда (No_Brand). Ручная обработка подключается только там, где алгоритм не уверен: за все время операторы обработали вручную порядка 43 тысяч SKU – создали новые эталонные записи (20 тысяч), сопоставили с существующим эталоном (7,9 тысячи) или отклонили задачи (15 тысяч).
В среднем ручное решение занимает пять дней от попадания в очередь до его принятия. Это не техническое ограничение – пайплайн доставляет такие задачи в UI почти мгновенно. Тут мы наглядно видим, для чего мы хотим увеличивать долю автоматического сопоставления.
Каждое автоматическое совпадение – это работа, которую не пришлось делать руками. Автоматический матчинг 1,29 миллиона позиций сэкономил около 3,6 тысячи часов ручной работы операторов или около 3,6 миллиона рублей. Расчет строился из стоимости часа в тысячу рублей и консервативной оценки времени на принятие ручного решения в 10 секунд – при более реалистичном тайминге экономия кратно выше.
Материал был опубликован в журнале «АвтоБизнесРевю»
№9 за 2026 год.

 0
 138


Комментарии
Чтобы оставлять комментарии, необходимо авторизоваться на сайте